Διαμάχη μαθηματικών γύρω από λύση της OpenAI τροφοδοτεί φόβους ότι η τεχνητή νοημοσύνη υπονομεύει την επιστήμη
Η είδηση στον χρόνο
Οι ενημερώσεις της ίδιας υπόθεσης, από τη νεότερη στην παλαιότερη.
- Διαμάχη μαθηματικών γύρω από λύση της OpenAI τροφοδοτεί φόβους ότι η τεχνητή νοημοσύνη υπονομεύει την επιστήμηΔιαβάζεις αυτή την ενημέρωση
- Ανησυχία μαθηματικών για τον ισχυρισμό της OpenAI ότι έλυσε πρόβλημα του Millennium Prize
Μια διαμάχη ανάμεσα σε μαθηματικούς γύρω από την επίλυση ενός από τα μεγάλα άλυτα προβλήματα των μαθηματικών τροφοδοτεί φόβους ότι η τεχνητή νοημοσύνη θα μπορούσε να υπονομεύσει την επιστήμη. Το περασμένο μήνα η OpenAI, η εταιρεία που δημιούργησε το ChatGPT, ανακοίνωσε ότι έλυσε με τους πράκτορες τεχνητής νοημοσύνης της πρόβλημα που σχετίζεται με τις διάσημες εξισώσεις Navier–Stokes, σε διάστημα 88 ωρών. Ο οργανισμός που χορηγεί βραβείο για όποιον λύσει το πρόβλημα δήλωσε ότι φαίνεται να έχει «προφανώς διευθετηθεί», σημειώνοντας όμως ότι η εξέτασή του θα απαιτούσε χρόνο.
Ωστόσο, λίγες ώρες πριν από την ανακοίνωση, ο μαθηματικός του Πανεπιστημίου της Νέας Υόρκης Tristan Buckmaster δημόσιοποίησε ανησυχίες. Είχε συγκροτήσει ανεξάρτητη ομάδα με τον Levent Alpöge, μαθηματικό που εργάζεται στη rival εταιρεία Anthropic. Οι δύο ερευνητές δούλευαν προς τον ίδιο στόχο και κρατούσαν τα προσχέδιά τους στο εργαλείο προγραμματισμού της OpenAI, το Codex. Ο Buckmaster ανέφερε ότι ο συνερευνητής του ειδοποιήθηκε ότι νέα για την πρόοδό τους είχαν «φτάσει» στην OpenAI, χωρίς να διευκρινίσει πώς. Ρώτησε αν η έρευνά τους, αποθηκευμένη στο Codex, θα μπορούσε να έχει τροφοδοτήσει το έργο της OpenAI, τονίζοντας ωστόσο ότι «δεν κατηγορεί κανέναν για τίποτα».
Η OpenAI απάντησε ότι κανένας στη компании, άνθρωπος ή τεχνητή νοημοσύνη, δεν είδε το έργο της άλλης ομάδας πριν δημοσιευτεί. Αρχικά δήλωσε ότι, αν και απίθανο, δεν μπορούσε να «αποκλείσει» το ενδεχόμενο ανωνυμοποιημένα δεδομένα από τη χρήση των προϊόντων της να έχουν βοηθήσει στη βελτίωση των μοντέλων της. Λίγες μέρες αργότερα υποστήριξε ότι οι εντολές του Buckmaster στο Codex τους δύο μήνες πριν από την ανακοίνωση «δεν θα μπορούσαν με κανέναν τρόπο να έχουν επηρεάσει το σύστημα».
Όπως σημειώνεται, δεν είναι ακόμη πλήρως γνωστό τι ακριβώς συνέβη, αλλά το περιστατικό αναδεικνύει ένα ευρύτερο ζήτημα: την πιθανότητα η τεχνητή νοημοσύνη να υπονομεύσει την πίστη στην επιστημονική διαδικασία, θέτοντας ερωτήματα για τη νεωτεριστικότητα και την ακρίβεια της έρευνας. Επιπλέον, καθώς τα ρομπότ συνομιλίας όπως το Claude και το Gemini παρουσιάζουν συχνά «ψευδαισθήσεις» — αναφέροντας πράγματα που δεν υπάρχουν — υπάρχει πλέον ενδεικτικά στοιχεία ότι το φαινόμενο εξαπλώνεται και στην επιστήμη, με φόβο ότι στο μέλλον θα είναι δύσκολο να διακρίνεται η πραγματική επιστημονική ανακάλυψη από την επινοημένη ιστορία που δημιούργησε τεχνητή νοημοσύνη.
Μια απειλή αφορά τα επιστημονικά περιοδικά, τους θεματοφύλακες της επιστημονικής ακεραιότητας, τα οποία θεωρείται ότι αδυνατούν να αντιμετωπίσουν ένα «τσουνάμι» παραμορφώσεων παραγόμενων από τεχνητή νοημοσύνη. «Η δημιουργική τεχνητή νοημοσύνη έχει ουσιαστικά διαταράξει ολόκληρη την επιστημονική διαδικασία», δήλωσε ο Dalmeet Singh Chawla, επιστημονικός δημοσιογράφος που καλύπτει επί μία δεκαετία την κακοδιαχείριση στην έρευνα. Ο ίδιος εκτίμησε ότι το προσωπικό ακεραιότητας των εκδοτών — όσοι ελέγχουν τις υποβολές για ακρίβεια και αξιοπιστία — θα πρέπει να αυξηθεί ριζικά σε αριθμό και προσπάθεια, προσθέτοντας ότι «αυτή τη στιγμή, φαίνεται ότι δεν το κάνουν».
Από την άλλη πλευρά, η τεχνητή νοημοσύνη έχει επιδείξει σημαντικά επιστημονικά επιτεύγματα. Το 2020 η εταιρεία Google DeepMind, με έδρα το Ηνωμένο Βασίλειο, έλυσε ένα από τα μεγαλύτερα προβλήματα της βιολογίας: πώς διπλώνουν οι πρωτεΐνες στις ακριβείς μορφές τους. Το μοντέλο AlphaFold προέβλεψε με ακρίβεια 200 εκατομμύρια πρωτεϊνικές δομές μέσα σε ένα χρόνο, ενώ το ισοδύναμο πειραματικό έργο θα απαιτούσε εκατοντάδες εκατομμύρια χρόνια σε εργαστήρια. Ο επικεφαλής του DeepMind και ο κύριος επιστήμονας του έργου τιμήθηκαν με το Νόμπελ Χημείας, ενώ ο Δρ Pushmeet Kohli, που ηγείται του επιστημονικού έργου της DeepMind, χαρακτήρισε το AlphaFold «στιγμή-ορόσημο».
Ωστόσο, αλλού η χρήση της τεχνητής νοημοσύνης στην επιστήμη έχει συνοδευτεί από κατηγορίες για υπερβολή. Ένα μοντέλο της DeepMind για την πρόβλεψη δομής νέων υλικών παρουσίασε δήθεν περισσότερες από δύο εκατομμύρια νέες κρυσταλλικές δομές, που ανακοινώθηκαν ως «γνώση 800 περίπου ετών» που δόθηκε με μία κίνηση. Δύο χημικοί του Πανεπιστημίου της Καλιφόρνια, οι Anthony Cheetham και Ram Seshadri, εξέτασαν τυχαίο δείγμα των υποτιθέμενων νέων κρυστάλλων και κατέληξαν, γράφοντας στο περιοδικό Chemistry of Materials, ότι «δεν έχουν βρει ακόμη καμία εντυπωσιακά νέα ένωση», υποστηρίζοντας ότι πολλές αποτελούν «τετριμμένες προσαρμογές γνωστών υλικών». Το συμπέρασμά τους δεν ήταν ότι η μέθοδος είναι λάθος, αλλά ότι τα αποτελέσματα χρειάζονται αυξημένο έλεγχο και επικύρωση από χημικούς. Η DeepMind απορρίπτει την κριτική, λέγοντας ότι δοκίμασε κάθε ένωση για νεωτεριστικότητα και σημειώνοντας ότι η αντικατάσταση ενός μόνο ατόμου είναι ο τρόπος με τον οποίο δημιουργήθηκαν πολλά από τα σημερινά χρήσιμα υλικά.
Μεγαλύτερη ανησυχία ενδέχεται να αποτελεί ο κίνδυνος τα επιστημονικά περιοδικά να μολυνθούν με το λεγόμενο AI «slop», όπου ο υπολογιστής και όχι ο άνθρωπος επιστήμονας γράφει την έρευνα, με ψεύτικες παραπομπές και εφηυρημένες εργασίες. Το 2024 ο καθηγητής πληροφορικής του Πανεπιστημίου της Γάνδης Dmitry Kobak έψαξε πάνω από ένα εκατομμύριο βιοϊατρικές ερευνητικές εργασίες για λέξεις-«σκανδάλες» που προτιμούν τα μοντέλα μεγάλης γλώσσας. Η ομάδα του διαπίστωσε ότι ως τον Δεκέμβριο εκείνου του έτους σχεδόν το 90% έφεραν δακτυλικά αποτυπώματα τεχνητής νοημοσύνης. Παρόλο που η τεχνολογία ανίχνευσης δεν είναι τέλεια, ο ίδιος δήλωσε ότι συγκλονίστηκε από την κλίμακα της εμφανούς χρήσης της ΤΝ και προειδοποίησε, σύμφωνα με όσα ανέφερε στο Nature, ότι υπάρχει κίνδυνος «όποια μεροληψία έχει το μοντέλο μεγάλης γλώσσας να διαποτίσει απότομα την επιστημονική βιβλιογραφία».
Επιπλέον, εκθέτεται σε πίεση και η διαδικασία της αξιολόγησης από ομότιμους, κατά την οποία οι ερευνητικές εργασίες ελέγχονται από άλλους επιστήμονες πριν δημοσιευθούν. Ομάδα υπό τους Weixin Liang και James Zou του Πανεπιστημίου Στάνφορντ ανέλυσε τις εκθέσεις κριτών που υποβλήθηκαν σε τέσσερις μεγάλες συνέδρια επιστήμης υπολογιστών και διαπίστωσε ότι έως και 17% του κειμένου είχε ουσιαστικά τροποποιηθεί από μοντέλο γλώσσας.
Περισσότερα από: Τεχνολογία
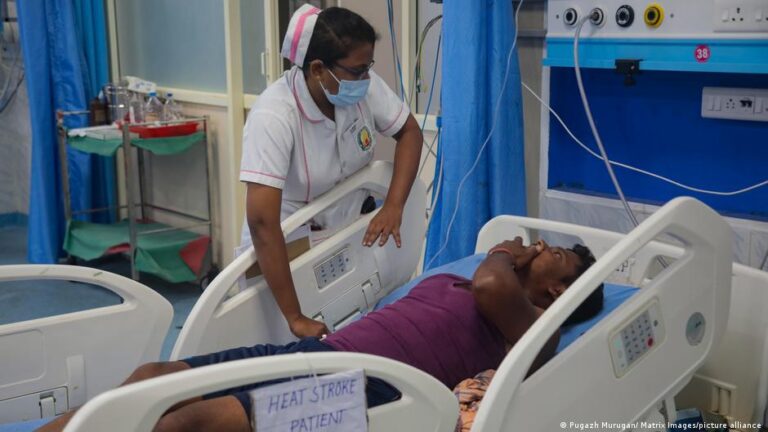
Εκατοντάδες ερευνητές ζητούν την κλιματική αλλαγή να κηρυχθεί παγκόσμια υγειονομική έκτακτη ανάγκη
Σχεδόν 150 ερευνητές από πάνω από 30 χώρες προειδοποιούν ότι οι θάνατοι από τη ζέστη, η ξηρασία και η επισιτιστική ανασφάλεια επιταχύνονται, και καλούν σε νέο διεθνές μηχανισμό συντονισμού.
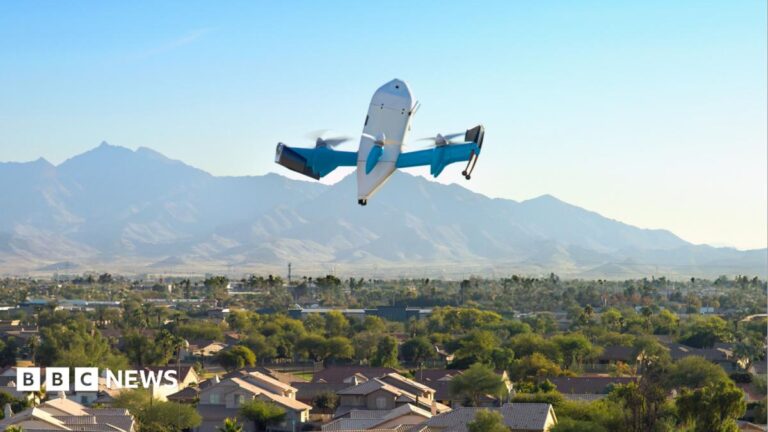
Το «εκνευριστικό βουητό» των drones παραδόσεων και η αναζήτηση πιο αθόρυβων μηχανημάτων
Καθώς τα drones παραδόσεων επεκτείνονται σε εκατοντάδες πόλεις των ΗΠΑ, αυξάνονται και τα παράπονα για τον θόρυβό τους.
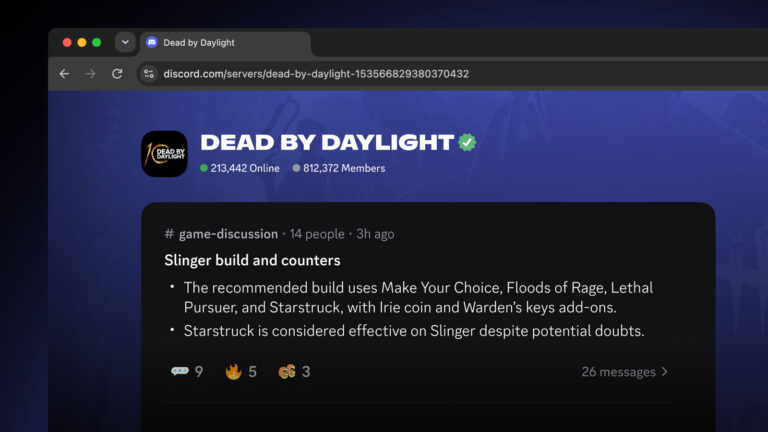
Το Discord θα κάνει τα μηνύματα δημόσιων servers αναζητήσιμα στη Google
Το Discord ανακοίνωσε αλλαγή πολιτικής βάσει της οποίας μηνύματα από τα λεγόμενα Discoverable Servers, τις κοινότητες τουλάχιστον 1.000 μελών, θα μπορούν στα μέσα Δεκεμβρίου να εμφανίζονται αυτούσια σε σελίδες web και σε αποτελέσματα αναζήτησης, με δυνατότητα εξαίρεσης για διαχειριστές και χρήστες.